引言
在當今數(shù)字化時代,軟件程序已成為社會運轉(zhuǎn)的基礎(chǔ)設(shè)施。從簡單的計算器到復(fù)雜的分布式系統(tǒng),軟件程序通過明確的規(guī)則和邏輯指令完成特定任務(wù)。而人工智能(AI)程序的興起,則標志著軟件范式的一次深刻變革:它不再僅僅依賴程序員手工編寫的確定性邏輯,而是通過數(shù)據(jù)驅(qū)動的方式,讓機器從經(jīng)驗中學(xué)習(xí)并做出決策。這一變革的核心,正是人工智能理論與算法軟件的開發(fā)。本文將探討傳統(tǒng)軟件程序與人工智能程序的區(qū)別,并深入分析人工智能理論與算法軟件開發(fā)的關(guān)鍵要素。
一、軟件程序:確定性邏輯的結(jié)晶
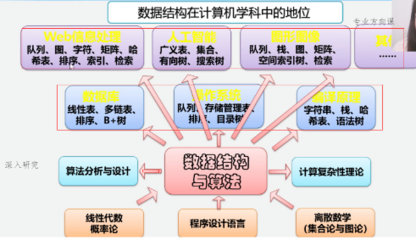
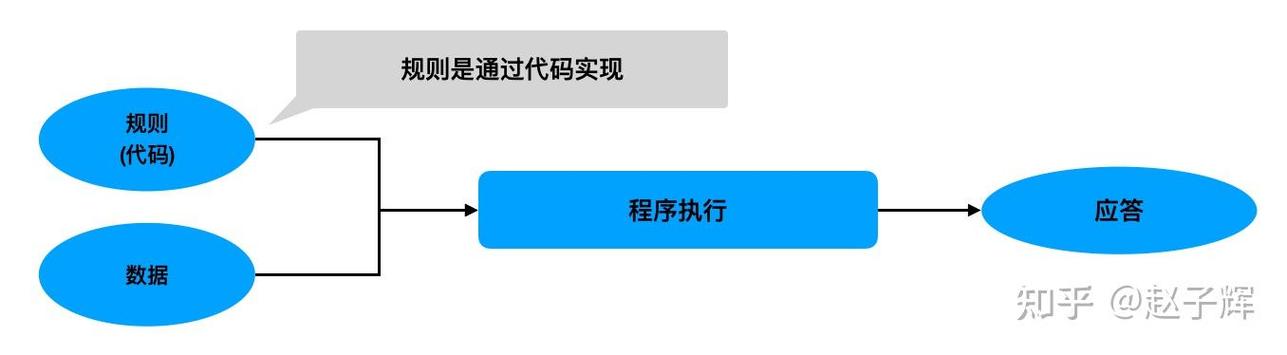
傳統(tǒng)軟件程序基于馮·諾依曼體系結(jié)構(gòu),其本質(zhì)是算法+數(shù)據(jù)結(jié)構(gòu)。程序員將業(yè)務(wù)邏輯分解為一系列明確的步驟,用編程語言表達為指令序列。軟件程序的行為完全由代碼決定,對于相同的輸入,只要運行環(huán)境一致,輸出總是確定的。例如,一個排序程序無論運行多少次,對同一組數(shù)據(jù)都會產(chǎn)生相同的排序結(jié)果。
軟件程序的開發(fā)過程通常遵循軟件工程方法:需求分析、設(shè)計、編碼、測試、維護。其核心挑戰(zhàn)在于管理復(fù)雜性、保證正確性和可維護性。對于許多現(xiàn)實世界的問題,如語音識別、圖像分類、自然語言理解,傳統(tǒng)軟件程序難以通過手工規(guī)則窮舉所有情況。這正是人工智能程序登場的背景。
二、人工智能程序:從數(shù)據(jù)中學(xué)習(xí)的智能
人工智能程序與傳統(tǒng)軟件程序的根本區(qū)別在于:其行為不是完全由程序員預(yù)先編寫的,而是通過訓(xùn)練數(shù)據(jù)自動調(diào)整模型參數(shù)而獲得的。一個AI程序通常包含一個參數(shù)化的模型(如神經(jīng)網(wǎng)絡(luò)),并通過學(xué)習(xí)算法從數(shù)據(jù)中優(yōu)化這些參數(shù)。訓(xùn)練完成后,模型可以對未見過的輸入進行預(yù)測或決策。
以圖像分類為例,傳統(tǒng)方法需要人工設(shè)計特征(如邊緣、紋理)并編寫分類規(guī)則,而AI程序只需提供大量標注圖像,模型便能自動學(xué)習(xí)到區(qū)分不同類別的特征。這種“數(shù)據(jù)驅(qū)動”的范式使AI程序在處理感知、預(yù)測和決策任務(wù)上超越了傳統(tǒng)軟件的能力邊界。
但AI程序也帶來新的挑戰(zhàn):其行為具有概率性和不透明性(黑箱問題),難以保證絕對正確性,且高度依賴訓(xùn)練數(shù)據(jù)的質(zhì)量和分布。因此,人工智能理論與算法軟件的開發(fā)成為一門融合數(shù)學(xué)、統(tǒng)計學(xué)、計算機科學(xué)與領(lǐng)域知識的交叉學(xué)科。
三、人工智能理論與算法軟件開發(fā)的核心內(nèi)容
人工智能理論與算法軟件開發(fā)涉及從基礎(chǔ)理論到工程落地的完整鏈條,主要包括以下幾個方面:
1. 數(shù)學(xué)與統(tǒng)計基礎(chǔ)
AI算法的根基是數(shù)學(xué)。線性代數(shù)用于表示向量、矩陣和張量運算;概率論與數(shù)理統(tǒng)計為不確定性建模提供框架;微積分和優(yōu)化理論支撐模型參數(shù)的迭代更新。例如,深度學(xué)習(xí)的反向傳播算法就是鏈式法則與梯度下降的結(jié)合。信息論、圖論、決策論等也在特定AI領(lǐng)域發(fā)揮關(guān)鍵作用。
2. 核心算法與模型
AI算法軟件的核心是各類學(xué)習(xí)算法及其模型結(jié)構(gòu)。常見的有:
- 監(jiān)督學(xué)習(xí):線性回歸、邏輯回歸、支持向量機、決策樹、隨機森林、神經(jīng)網(wǎng)絡(luò)等。
- 無監(jiān)督學(xué)習(xí):聚類(K-means、DBSCAN)、降維(PCA、t-SNE)、生成模型(GAN、VAE)。
- 強化學(xué)習(xí):Q-learning、策略梯度、Actor-Critic、深度強化學(xué)習(xí)(DQN、PPO)。
- 深度學(xué)習(xí):卷積神經(jīng)網(wǎng)絡(luò)(CNN)、循環(huán)神經(jīng)網(wǎng)絡(luò)(RNN)、Transformer、圖神經(jīng)網(wǎng)絡(luò)(GNN)。
這些算法的軟件實現(xiàn)需要高效計算,通常借助GPU、TPU等硬件加速,并使用框架如TensorFlow、PyTorch、JAX等。
3. 數(shù)據(jù)工程與特征工程
數(shù)據(jù)是AI程序的燃料。數(shù)據(jù)工程包括數(shù)據(jù)采集、清洗、標注、增強和劃分。特征工程在傳統(tǒng)機器學(xué)習(xí)中至關(guān)重要,而在深度學(xué)習(xí)中,模型可以自動學(xué)習(xí)特征表示,但數(shù)據(jù)質(zhì)量仍然決定模型上限。算法軟件需要提供數(shù)據(jù)管道、預(yù)處理組件和版本管理工具。
4. 模型訓(xùn)練、評估與調(diào)優(yōu)
訓(xùn)練是將算法作用于數(shù)據(jù)以優(yōu)化模型參數(shù)的過程。軟件需要實現(xiàn)損失函數(shù)、優(yōu)化器、正則化、批處理等技術(shù)。評估則通過準確率、精確率、召回率、F1值、AUC等指標衡量模型性能,并使用交叉驗證、留出法等方法。超參數(shù)調(diào)優(yōu)(網(wǎng)格搜索、隨機搜索、貝葉斯優(yōu)化)也是算法軟件的重要功能。
5. 部署與運維(MLOps)
將訓(xùn)練好的模型部署到生產(chǎn)環(huán)境是AI軟件開發(fā)的最后一公里。這涉及模型序列化、服務(wù)化(REST API、gRPC)、監(jiān)控、漂移檢測和持續(xù)再訓(xùn)練。MLOps(機器學(xué)習(xí)運維)將DevOps理念擴展到AI系統(tǒng),確保模型可靠、可復(fù)現(xiàn)、可擴展。
6. 倫理、安全與可解釋性
隨著AI廣泛應(yīng)用,算法公平性、隱私保護、對抗魯棒性和可解釋性成為不可或缺的開發(fā)要素。算法軟件需內(nèi)置偏差檢測、差分隱私、對抗訓(xùn)練和解釋工具(如SHAP、LIME)。
四、開發(fā)實踐與工具鏈
現(xiàn)代AI算法軟件開發(fā)已形成成熟的工具生態(tài):
- 編程語言:Python憑借豐富的庫(NumPy、Pandas、Scikit-learn)成為主流,C++用于高性能內(nèi)核,Julia和R則用于科學(xué)計算。
- 深度學(xué)習(xí)框架:PyTorch(動態(tài)圖, ??友好)、TensorFlow(生產(chǎn)部署強)、JAX(函數(shù)式,自動微分)。
- 實驗管理:MLflow、Weights & Biases、TensorBoard用于跟蹤實驗。
- 分布式訓(xùn)練:Horovod、Ray、PyTorch Distributed支持多機多卡。
- 模型壓縮與加速:剪枝、量化、知識蒸餾用于邊緣部署。
軟件開發(fā)方法論(敏捷、迭代)同樣適用于AI項目,但由于其探索性,需要更強調(diào)實驗和快速原型。
五、挑戰(zhàn)與未來方向
人工智能理論與算法軟件開發(fā)仍面臨諸多挑戰(zhàn):
- 理論瓶頸:深度學(xué)習(xí)缺乏嚴格的理論解釋,泛化能力、優(yōu)化 landscape 仍是開放問題。
- 數(shù)據(jù)依賴:獲取高質(zhì)量標注數(shù)據(jù)成本高昂,小樣本學(xué)習(xí)、自監(jiān)督學(xué)習(xí)成為熱點。
- 計算資源:大模型訓(xùn)練能耗巨大,綠色AI亟待發(fā)展。
- 系統(tǒng)復(fù)雜性:AI系統(tǒng)與傳統(tǒng)的軟件組件交織,測試和調(diào)試困難。
- 安全與倫理:對抗攻擊、深度偽造、算法偏見威脅社會信任。
未來趨勢包括:神經(jīng)符號整合、因果推理、元學(xué)習(xí)、聯(lián)邦學(xué)習(xí)、AI芯片專用化,以及AI與量子計算的結(jié)合。
##
軟件程序與人工智能程序并非取代關(guān)系,而是互補共生。傳統(tǒng)軟件提供確定性、可驗證的控制邏輯,AI程序賦予系統(tǒng)感知、預(yù)測和自適應(yīng)能力。人工智能理論與算法軟件開發(fā),正是將數(shù)學(xué)理論、學(xué)習(xí)算法和工程實踐深度融合,構(gòu)建出能夠從數(shù)據(jù)中汲取智慧的新型軟件。掌握這一領(lǐng)域,不僅需要扎實的計算機科學(xué)功底,還需跨越數(shù)學(xué)、統(tǒng)計學(xué)和領(lǐng)域知識的邊界。隨著技術(shù)演進,AI算法軟件將繼續(xù)拓展軟件工程的疆界,推動智能時代的創(chuàng)新。